使用NVIDIA Blackwell和GPU加速端点构建DeepSeek V4大模型
DeepSeek 刚刚发布了第四代旗舰模型,推出DeepSeek-V4-Pro和DeepSeek-V4-Flash两款产品,均致力于实现高效的百万词元上下文推理。
DeepSeek-V4-Pro 是该系列中最大的型号,拥有 1.6 T 的总参数和 49B 的活动参数。DeepSeek-V4-Flash 是一款包含 304B 参数的小型模型,具有 130 亿个活动参数,专为高速、高效的工作负载而设计。这两种模型最高支持 1M- 词元上下文窗口,为长上下文编码、文档分析、检索和代理式 AI 工作流开辟了新的可能性。
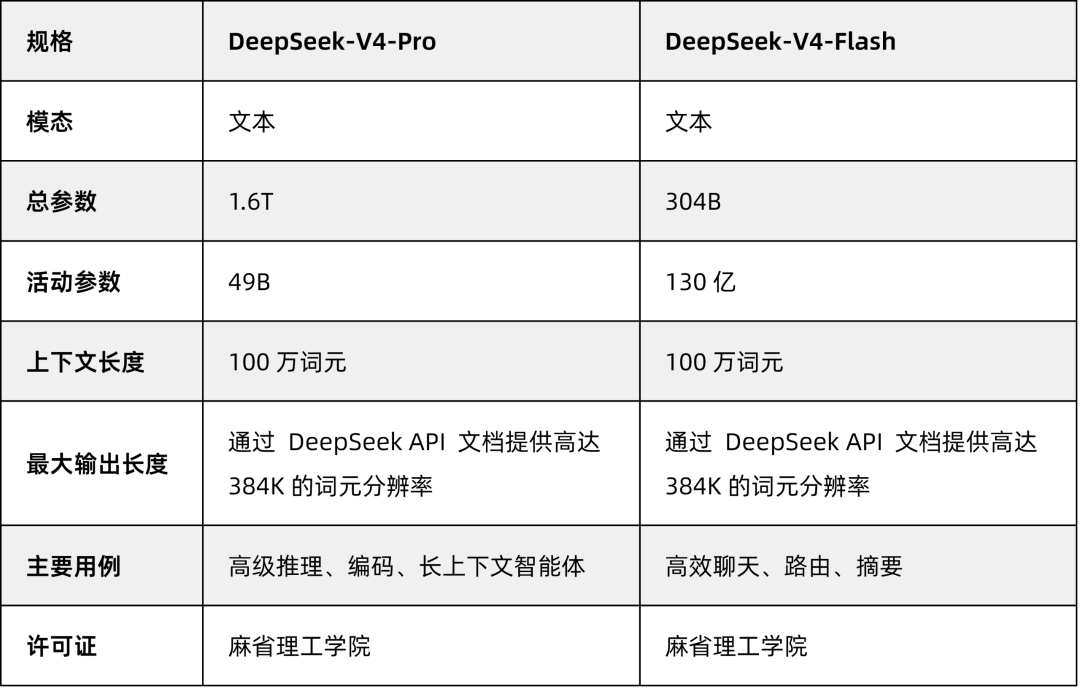
表 1. DeepSeek V4 系列的规格。
用于长上下文推理的架构创新
V4 系列基于 DeepSeek MoE 架构构建,重点优化了 Transformer 架构中的注意力组件。相比DeepSeek-V3.2,这些创新可将每个词元推理所需的 FLOPs 减少 73%,并将 KV 缓存的内存负载降低 90%。
这一点很重要,因为长上下文正在成为代理式应用的核心要求。智能体可以存储多个提示和响应。它们在整个工作流程中携带系统指令、工具输出、检索到的上下文、代码、日志、内存和多步骤推理痕迹。随着上下文窗口的增长,注意力和 KV 缓存成为主要瓶颈。
图 1. DeepSeek-V4 混合注意力架构概述。通过结合 CSA、DSA 和 HCA,该模型显著减少了标准 Transformer 块内的 KV 缓存内存占用和计算开销。
应对这一挑战的核心架构解决方案是混合注意力,它融合了:
压缩稀疏注意力(CSA):通过动态序列压缩来减少 KV 条目的数量,从而降低 KV 缓存的内存占用,再结合 DeepSeek 稀疏注意力(DSA)对注意力矩阵进行稀疏化,以降低计算开销。
严重压缩注意力(HCA):通过将多个词元集合中的键值(KV)条目合并为单个压缩条目,实现更激进的压缩,从而显著减小 KV 缓存的大小。
DeepSeek-V4 的架构创新标志着从基本聊天系统向多回合、长上下文推理和代理式系统的转变。这种新范式强调了整个堆栈 (软件、内存、计算和网络) 从根本上改变了推理经济学的动态。随着开放模型达到智能的前沿,企业的工作重点从模型选择转向基础设施策略。在这种情况下,最终的竞争优势是能够以最低的词元成本部署和扩展这些高性能模型。
开箱即用的 NVIDIA Blackwell 性能见解
无论是开发者部署用于高级推理的 1.6 T Pro 模型,还是用于实现高速效率的 284B Flash 模型,Blackwell 都能提供 100 万长上下文推理和万亿参数智能新时代所需的规模和低延迟性能。
NVIDIA Blackwell 平台专为此类工作负载而构建。在基于 NVIDIA GB200 NVL72 的 DeepSeek-V4-Pro 上进行的开箱即用测试表明,词元/ 秒/ 用户数超过 150。除了这些初步测试之外,NVIDIA 团队还利用 vLLM 的 Day 0 NVIDIA Blackwell B300 recipe 生成了开箱即用的性能快照 (图 2) 。
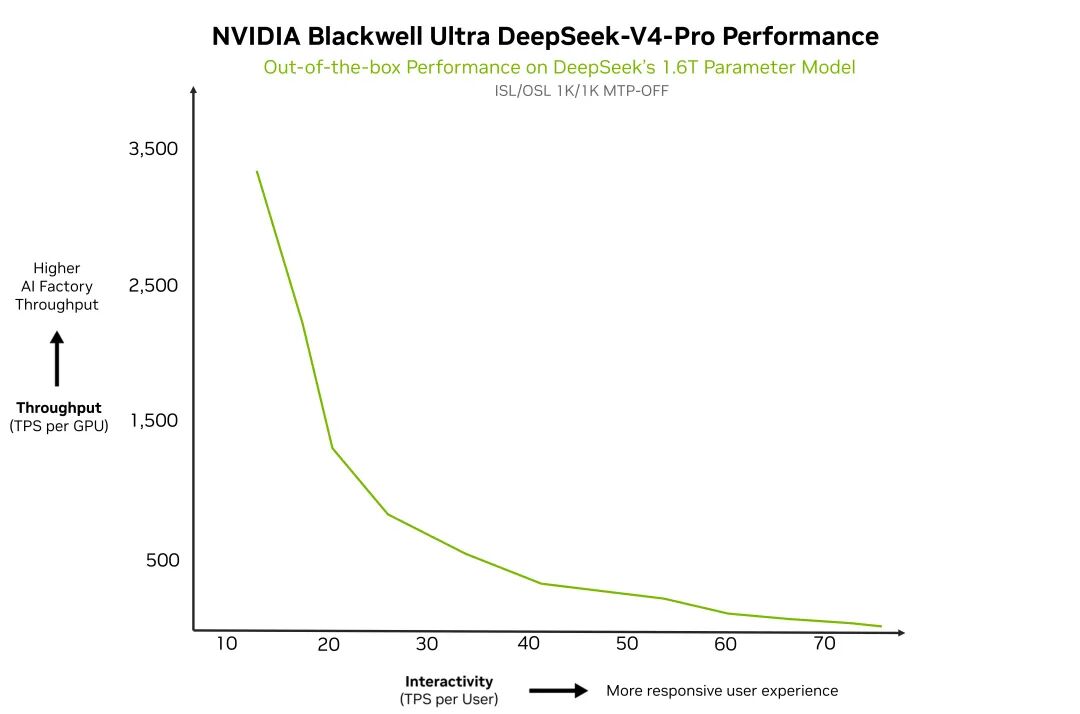
图 2. DeepSeek-V4-Pro 在 NVIDIA Blackwell B300 上的开箱即用性能。结果基于使用该模型的原生 MXFP4 格式的 1K/ 1K ISL/ OSL 配置。
随着我们优化整个极致协同设计堆栈 (包括 Dynamo、NVFP4、经过优化的 CUDA 内核、高级并行技术等) ,这一性能有望进一步提升。
使用 NVIDIA GPU 加速端点进行构建
作为 NVIDIA 开发者计划的一部分,开发者可通过 nvidia.com 上由 NVIDIA GPU 加速的端点(https://build.nvidia.com/)(复制链接至浏览器打开,下同),开始使用 DeepSeek V4 进行开发。在转向自托管部署之前,托管端点为使用最新模型进行原型设计提供了快速便捷的方式。
借助 NVIDIA NIM,DeepSeek V4 也可在首发日下载,因此可以部署它,使用熟悉的 API 模式构建长上下文编码、文档分析和智能体工作流。
使用 SGLang 进行部署
SGLang 为基于 NVIDIA Blackwell 和 Hopper 架构的 DeepSeek V4 提供三种主要服务方案,分别针对不同的延迟与吞吐量需求(低延迟、均衡性能和最大吞吐量)进行优化,同时还提供专为长上下文工作负载以及预填充与解码分解设计的定制化方案。
使用 vLLM 进行部署
vLLM 为 NVIDIA Blackwell 和 Hopper 提供 DeepSeekV4 的单节点与多节点服务方案,支持扩展至 100 多个 GPU 的多节点预填充与解码分离架构,并具备工具调用、推理及预测解码能力。
助力智能体工作流
DeepSeek V4 特别适合智能体,因为它在长上下文编排、推理和工具调用方面表现出色。首先,开发者可以将 DeepSeek V4 配置为 LLM:
NVIDIA NemoClaw:在安全的 OpenShell 环境中运行 OpenClaw,利用 DeepSeek V4 构建可长期运行的个人助手,适用于代码生成、个人事务处理、自主支持等任务。运行nemoclaw onboard,在第 3 步中输入您的 DeepSeek V4 提供商 URL 及其 DeepSeek V4 模型名称。
NVIDIA AI-Q blueprint:为您提供或您的代理一个强大的深度研究助手。该蓝图基于 LangChain 深度代理,具备良好的可扩展性,可轻松将 DeepSeek V4 集成到您的工作流程中,实现高效的编排与规划.
NVIDIA Data Explorer 智能体:在 DABstep 基准测试中排名第一,擅长数据分析、数据科学和表格研究。该智能体基于 NeMo Agent Toolkit 构建,可轻松切换至 DeepSeek V4。
使用开放智能体工具和开放模型的最佳方式是,您始终能够尝试新的模型来获取前沿技术。
开始使用 DeepSeek
从 NVIDIA Blackwell 上的数据中心部署到托管 NIM 微服务和微调工作流,NVIDIA 提供了一系列选项,用于在不同的开发和部署阶段集成 DeepSeek 和其他开放模型。NVIDIA 是开源生态系统的积极贡献者,已根据开源许可证发布了数百个项目。NVIDIA 致力于优化社区软件和开放模型,让用户广泛分享在 AI 安全性和弹性方面的工作。
如需开始使用,请前往 Hugging Face 查看 DeepSeek-V4(https://huggingface.co/collections/deepseek-ai/deepseek-v4),或在 build.nvidia.com(https://build.nvidia.com/deepseek-ai/deepseek-v4-pro)上体验专业版。
- 9月交付7327台创历史新高 firefly萤火虫领跑高端小车市场
- AIVA ME7巴黎全球首秀 仿生设计落地首款量产车
- 限时售14.99万起 深蓝S07 AI激光版上市 800V平台/续航最高725km
- 全程3605公里! 蔚来丝绸之路换电路线正式贯通
- 奕境X9满配华为乾崑全栈智能 售27.98万元起
- 捷途旅行者7预售14.99万起 燃油/插混动力 纯电续航251km
- 广汽传祺越7上市 权益价16.18万元起
- 选装价1.08万起 蔚来ES8推出揽月套装 22英寸锻造轮圈+曙光金卡钳
- 预售26.98万起 智界RX新增两款车型 搭载81度电池/续航702km
- 双车交出亮眼成绩单 蔚来ES9、全新ES8各自领跑细分市场
- 极氪9X德国市场起售价约93万元 成为欧盟售价最高中国量产车
- 成都丰田普拉多中东版最高降7.8万 欢迎前来试驾
- 高新西皓影新能源价格16.59万起 优惠高达6.00万
- 中创新航合肥研究院正式落地
- UAES-新一代车载充配电单元CharCON5U | 申报2026第八届金辑奖最佳技术实践应用奖
- 用得爽!七部门新政给老百姓的用车红利清单